
GPU 资源更高效,AI 基础设施运维更简单
AstraGo 是从 GPU 资源分配、工作负载执行到运维管理, 均在单一环境中支撑的企业级 AI 基础设施平台。
AstraGo 核心功能
资源分配
按照所需作业高效分配 GPU 资源
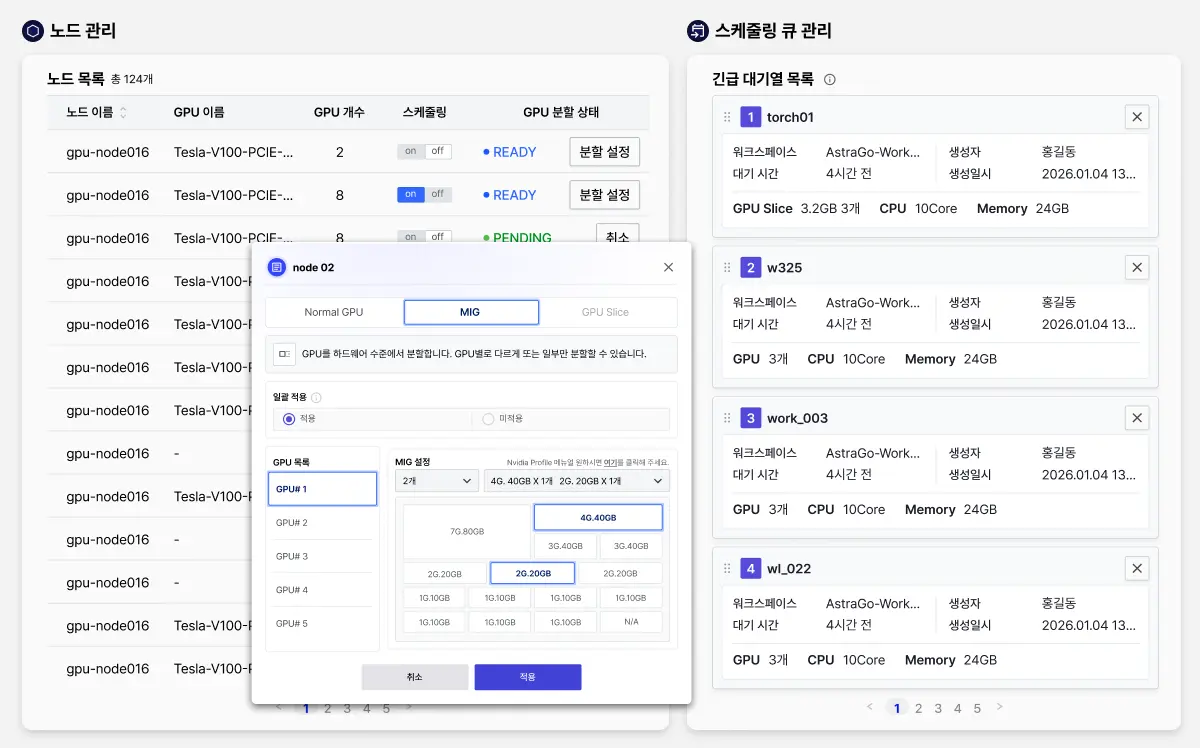
工作负载执行
将 AI 训练与推理作业稳定地运行
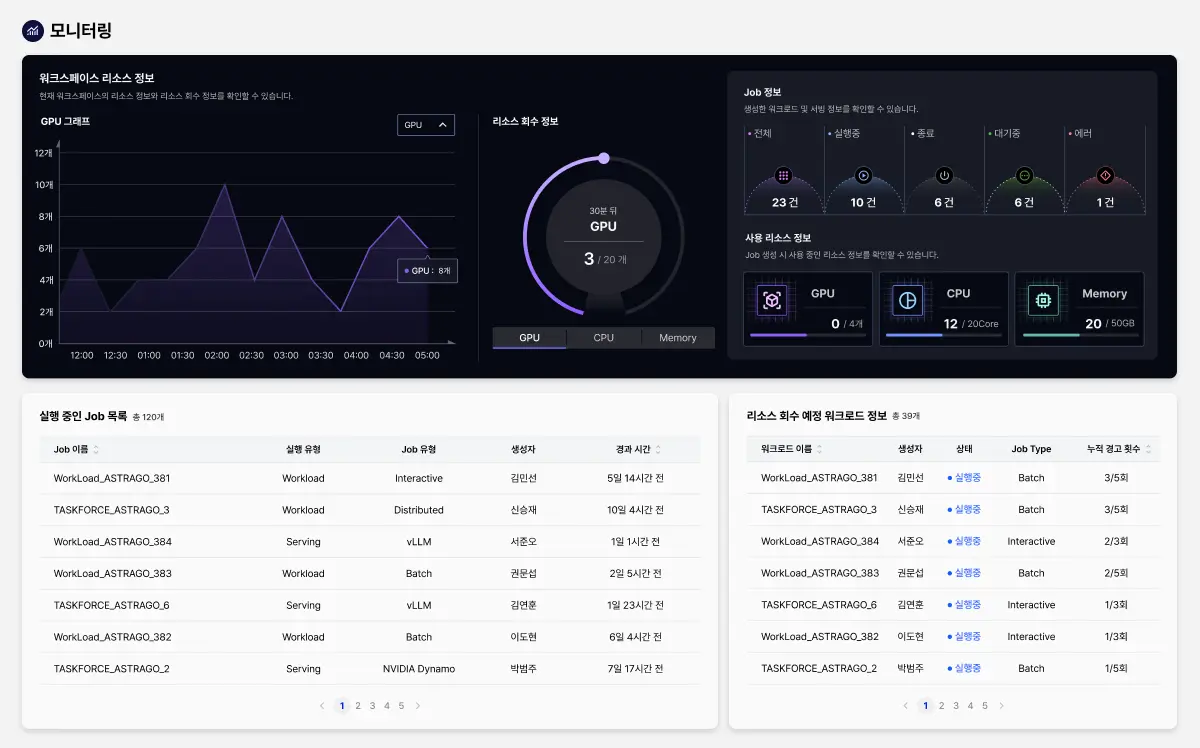
运维管理
基于 Kubernetes统一管理 GPU 资源与工作负载
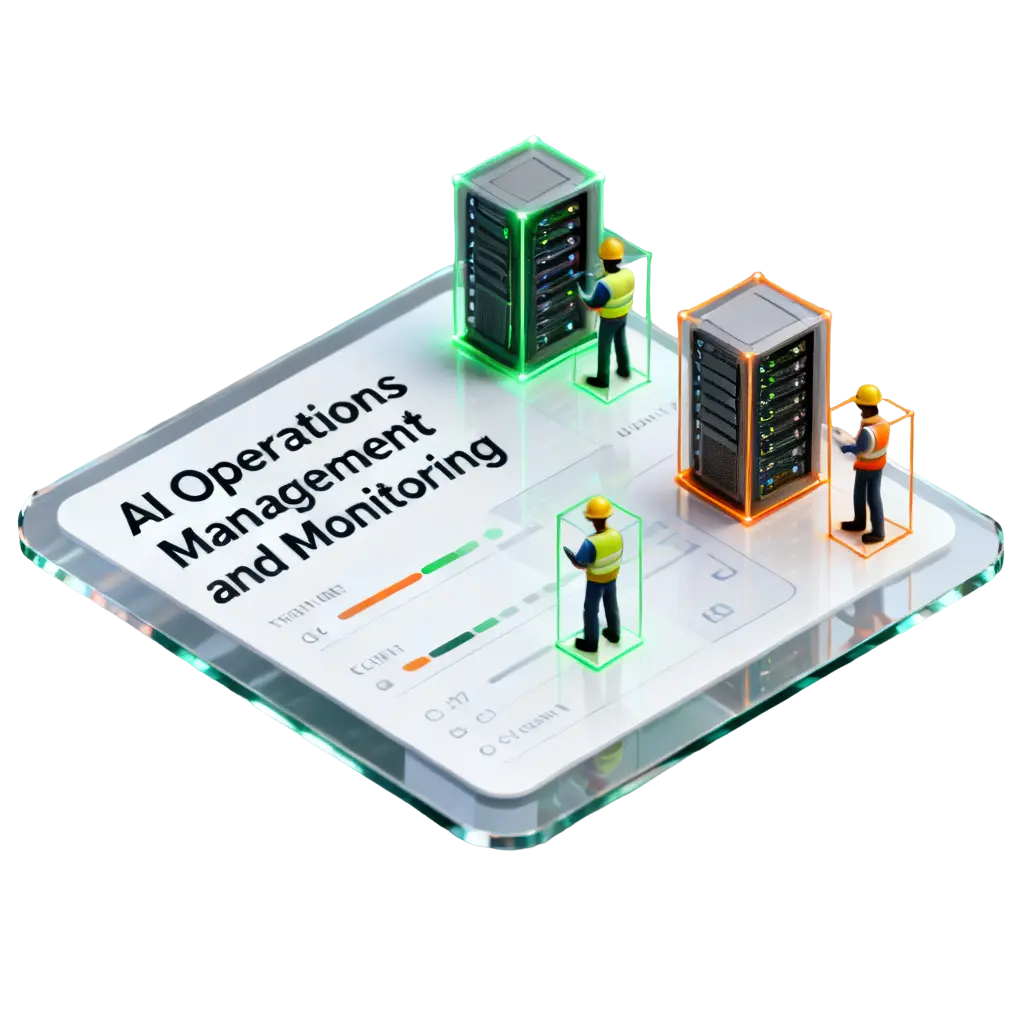
将复杂的 GPU 基础设施运维整合到单一平台
管理各组织与项目的资源和权限。
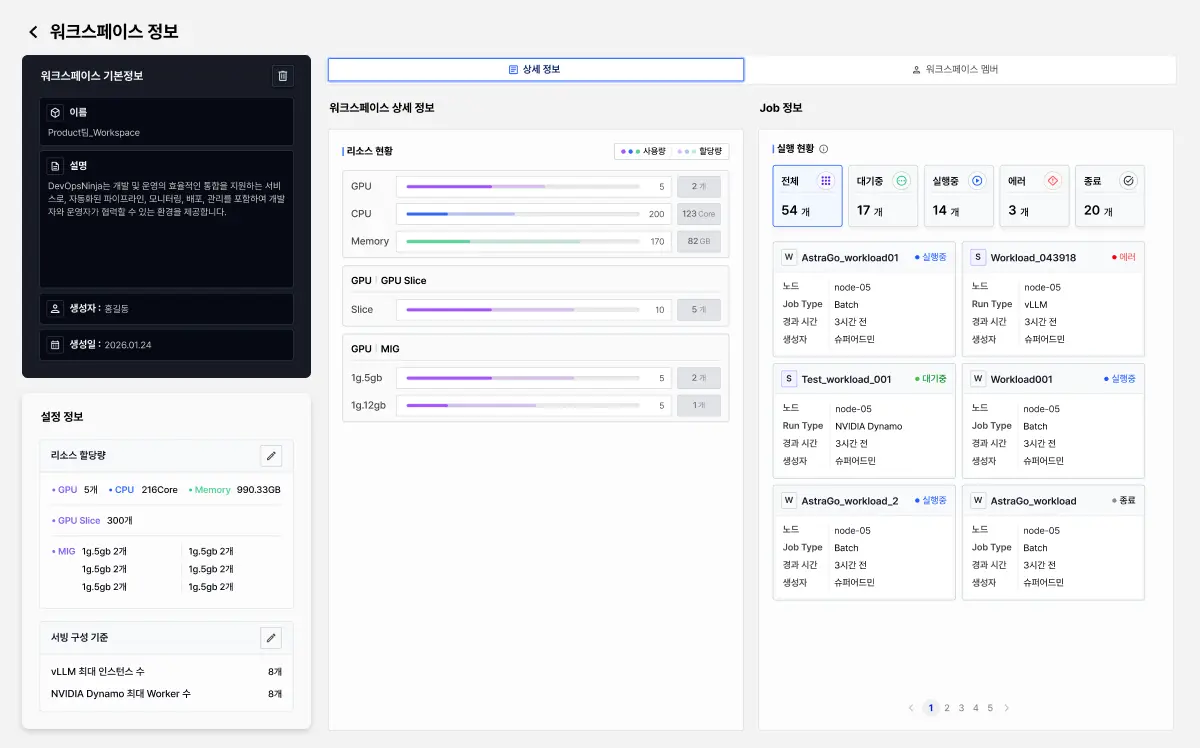
通过调度与 GPU 切分优化资源利用。
实时掌握 GPU 与工作负载状态。
运维更加简单,GPU 利用率随之提升。
GPU 利用率
提升 53%
部署时间
缩短 99%
隔离网络环境建设
最短 2 周
* 依据实际建设案例,结果可能因应用环境而异。

先行诊断 GPU 基础设施效率的AstraMon
分析 GPU 使用现状与成本效益,并通过改善效果仿真提出运维优化方向。请用 AstraMon 诊断当前的运维状态,并以 AstraGo 优化 GPU 基础设施运维。
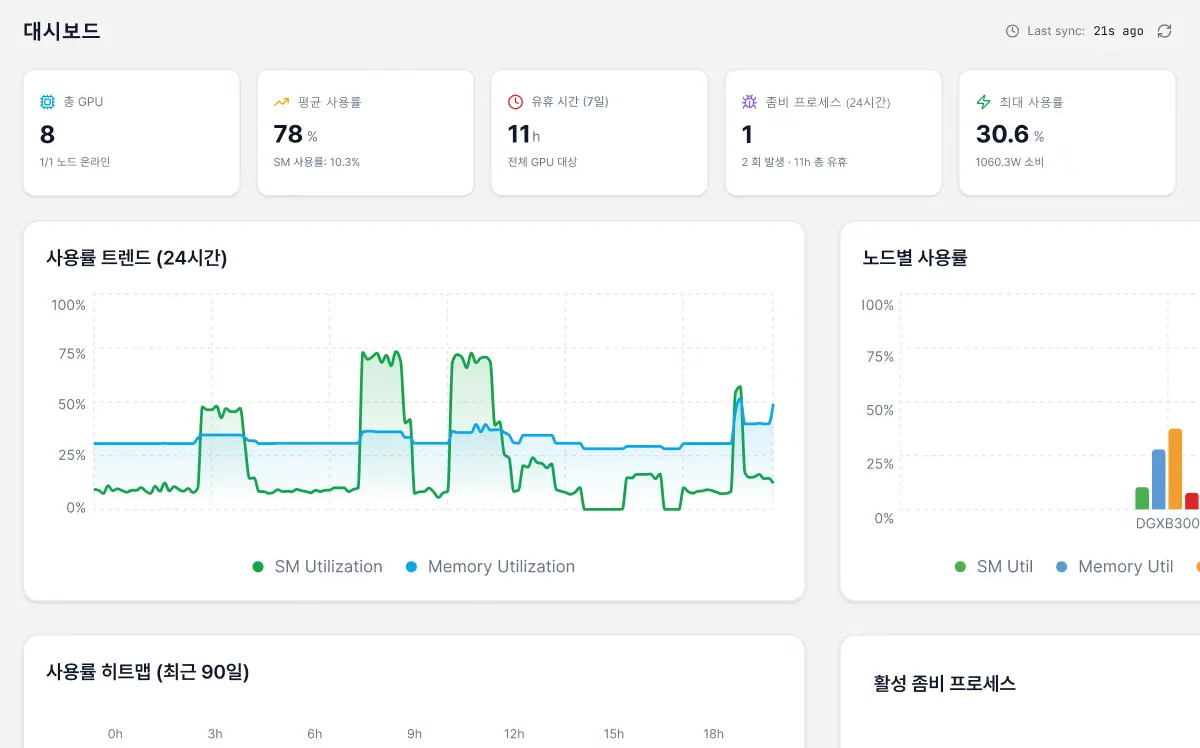
GPU 监控
平均 GPU 利用率、闲置时间、分星期与时段的热力图等 GPU 基础设施现状一目了然
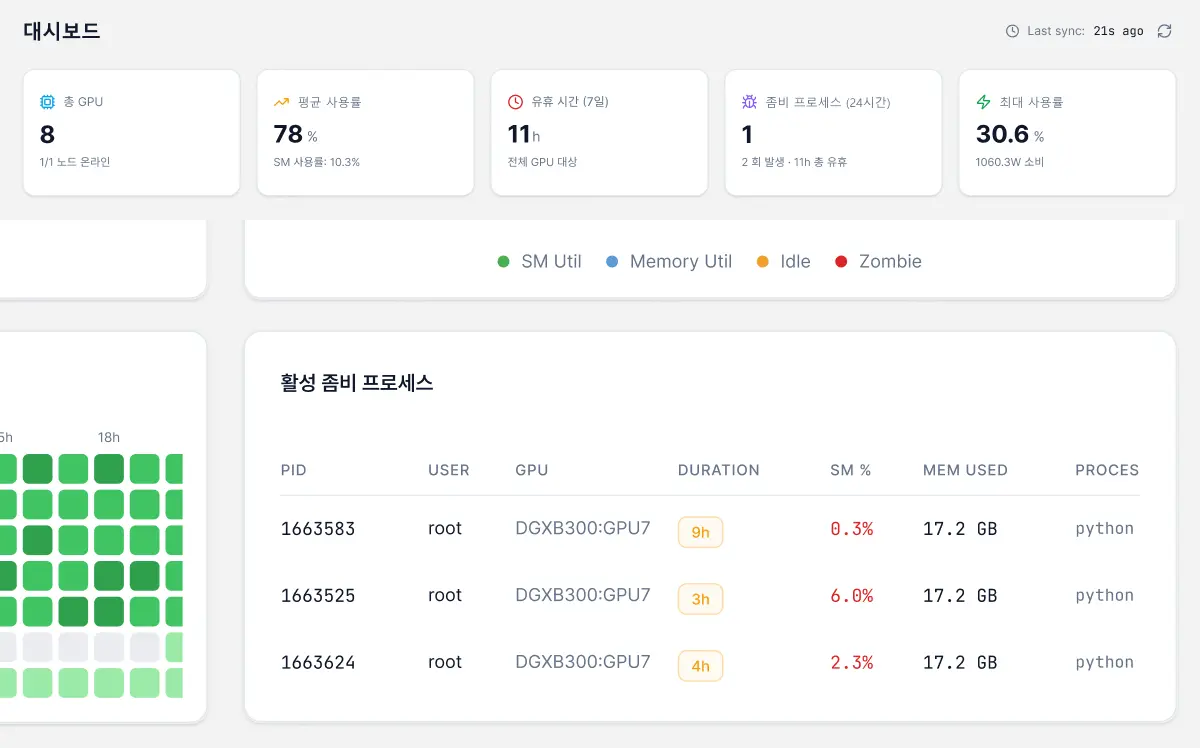
僵尸进程检测
自动检测占用 GPU 内存但实际未进行计算的进程
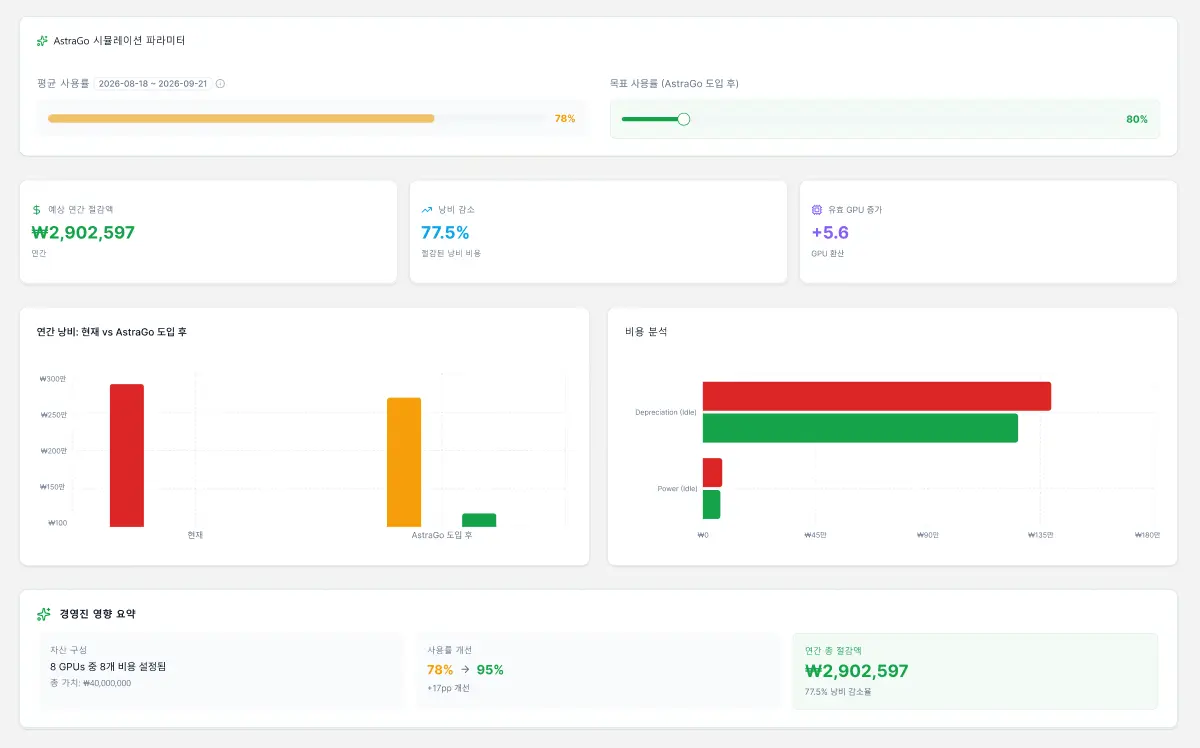
将低效折算为金额
通过 AstraGo 导入仿真给出预计年度节省金额
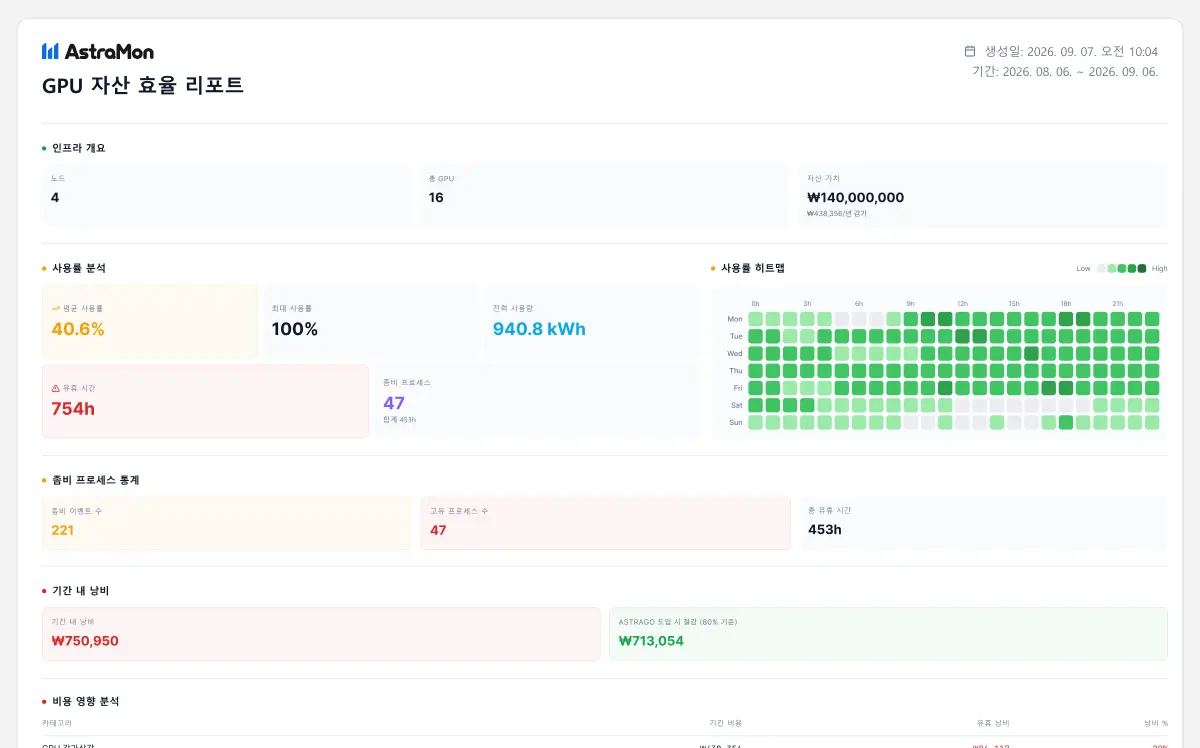
自动生成报告
自动生成可立即使用的管理层报告

欢迎查看常见问题
VIEW ALL现有的 GPU 服务器也能部署 AstraGo 吗?
可以。AstraGo 能够部署在现有的 NVIDIA GPU 服务器及 NPU(FuriosaAI、DeepX)上,异构 GPU 也可在同一平台统一管理。我们会先分析现有基础设施环境与需求,再设计并搭建适合贵司环境的 GPU 集群架构。
想了解 AstraGo 支持哪些 GPU 环境。
AstraGo 支持 NVIDIA GPU 全系列型号,并可按本地化部署环境进行设计。它同时支持 AI 训练与推理工作负载,可对由多台服务器组成的 GPU 集群进行统一管理。
希望在隔离网络环境中使用 AstraGo。
AstraGo 可在隔离网络等对安全性要求较高的环境中使用。我们会结合贵司的安全与网络环境进行部署,并支持贴合本地化部署环境的运维方式。
部署后如何获得技术支持?
部署时将指派 1 名专属开发人员,直接提供技术支持。发生故障时,专属工程师也会查明原因并进行处理,并提供远程或现场技术支持。我们还提供运营培训、系统配置变更、集成与应用部署等运营所需的技术支持。
希望同时运行 AI 训练与推理工作负载。
AstraGo 同时支持 AI 训练与推理工作负载。可按工作负载切分并分配 GPU 资源,优化资源利用率,使一块 GPU 能够同时运行多个工作负载。
引入前可以先验证效果吗?
可以。可在贵司环境中进行概念验证(PoC),先行验证效果。PoC 的周期与范围等具体条件将另行协商。
部署需要多长时间?
视安全、网络、存储、外部系统对接等定制化程度而定,大约需要 2 周至 2 个月。
费用是如何构成的?
费用由年度订阅许可与按节点计算的服务器安装费构成。如需定制开发,将另行协商。
能否安装在正在运行的服务器或 Kubernetes 环境中?
对于正在运行的服务器,会先安装 Kubernetes,再安装 AstraGo。已在运行 Kubernetes 的环境也可以安装,但可能与现有软件发生冲突,因此安装前将由负责人员事先确认。
电源管理是如何运作的?
在训练、微调等批处理任务运行期间,会自动调整 GPU 功耗上限。任务结束或功能停止后,GPU 设置会自动恢复为默认值。
支持哪些 NPU?
目前支持 FuriosaAI 与 DeepX 的 NPU,可用于 DeepX ModelZoo 中视觉模型(目标检测、图像分类)的推理服务。
AI Agent 可以连接哪些 AI 工具?
通过 MCP 方式连接,已在 Claude Code 中完成验证,同时也支持 Codex 与 ChatGPT。
AstraMon 是什么产品?
AstraMon 是一款诊断 GPU 基础设施实际使用状况的解决方案。可以了解当前 GPU 的使用效率,并预先确认引入 AstraGo 后预计可节省的成本。
通过 AstraMon 可以了解哪些内容?
监测 GPU 使用率、闲置时间与待机功耗,以数值形式计算 GPU 闲置成本。还可模拟 GPU 利用率变化带来的节省效果,并以综合运营报告的形式提供结果。
第 1 页